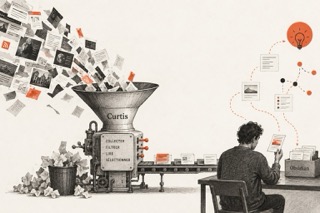
J’ai commencé à construire Curtis parce que ma veille produisait plus d’informations que je ne pouvais raisonnablement en traiter. Feedly faisait une partie du travail : agréger des sources, signaler de nouveaux contenus, multiplier les occasions de lire quelque chose d’intéressant. Le problème commençait ensuite. Il fallait lire, sélectionner, conserver ce qui méritait de l’être, puis réussir à le retrouver quelques semaines plus tard.
Je voulais donc fermer cette boucle. Curtis devait collecter des informations publiques, filtrer le bruit, lire les contenus, produire une sélection, puis me permettre de conserver volontairement les plus utiles dans un second cerveau Obsidian. Une fois mémorisées, ces notes devaient pouvoir être retrouvées par leur sens, reliées à d’autres connaissances et réutilisées pour répondre à une question ou faire émerger une idée d’article.
Actuellement, Curtis surveille 161 sources actives, dont 139 flux RSS et 22 sources accessibles par URL. Douze topics complètent cette base par de la recherche. Mon index sémantique contient 105 notes et 159 fragments vectoriels.
J’ai construit Curtis par itérations
Curtis a été largement vibe-codé. Je n’avais pas au départ une architecture complète qu’il aurait suffi de transformer en code. J’avançais plutôt à partir d’un comportement attendu : je décrivais la vision / les features de ce que je voulais obtenir, je construisais une première version, puis je la confrontais à des cas réels.
Cette méthode raccourcit fortement le passage entre une idée et une implémentation. Elle ne supprime cependant pas le travail de conception. Dans mon cas, elle l’a déplacé. Une fois la première version en fonctionnement, il fallait observer précisément ce qu’elle faisait, distinguer un bug d’un mauvais choix d’architecture, puis transformer ce constat en nouvelle règle.
La boucle de travail ressemblait à ceci :
vision → implémentation → test réel → comportement indésirable → contrainte → nouvelle implémentation
Une grande partie de l’architecture actuelle est le résultat de cette accumulation de corrections. Le routage déterministe, les permissions, les validations intermédiaires ou encore la séparation des différentes mémoires n’ont pas été ajoutés pour rendre un schéma d’architecture plus élégant. Ils répondent à des problèmes rencontrés pendant l’usage.
Ma première architecture faisait trop confiance au modèle
Un premier essai permettait au modèle local de consulter mon vault Obsidian au moyen d’un outil MCP. L’idée semblait raisonnable : le modèle disposait de l’outil et recevait des instructions lui indiquant quand l’utiliser. Le problème est qu’il pouvait aussi répondre sans l’appeler.
Pour une conversation ordinaire, ce comportement peut parfois être acceptable. Pour Curtis, il introduisait une ambiguïté gênante : une réponse pouvait avoir l’apparence d’une recherche dans mon second cerveau sans que cette recherche ait réellement eu lieu.
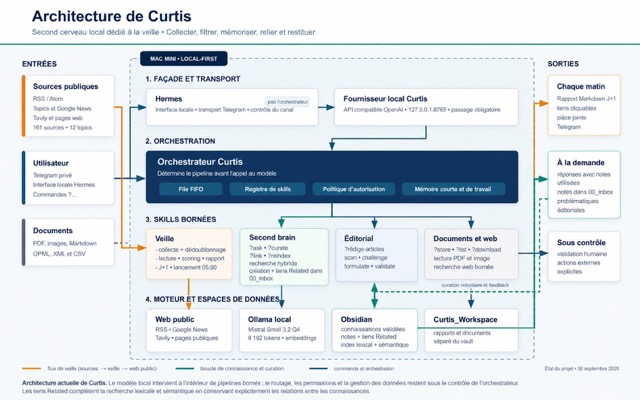
J’ai donc déplacé cette décision en amont du LLM. Hermes reste l’interface locale et le transport, notamment pour Telegram, mais les messages passent ensuite par un fournisseur Curtis compatible avec l’API OpenAI, exposé uniquement sur un fournisseur local Curtis accessible uniquement depuis le Mac mini. Derrière lui, un orchestrateur détermine le pipeline à exécuter, gère la file FIFO, les skills et les autorisations avant d’appeler le modèle local (mistral-small) via Ollama.
Avec ?ask, par exemple, Curtis ne demande pas au modèle s’il souhaite rechercher dans Obsidian. Il exécute une recherche hybride. Une première composante est lexicale et travaille sur le titre, les topics, le chemin et le contenu des notes. La seconde utilise des embeddings locaux produits avec nomic-embed-text:latest. Les résultats sont fusionnés et au maximum huit notes candidates sont envoyées au modèle pour construire la réponse.
Le LLM garde donc un espace d’interprétation important, mais il intervient à l’intérieur d’un pipeline dont certaines étapes sont imposées. Lorsqu’une opération est indispensable au résultat, je préfère désormais l’inscrire dans l’orchestration plutôt que dépendre d’une instruction adressée au modèle.
Les garde-fous sont venus des problèmes rencontrés
La création de notes a suivi la même évolution. Dans une première version, fournir une URL pouvait suffire à produire une note dans Obsidian. Cela supprimait une friction, mais mélangeait deux décisions différentes : demander à Curtis de lire un contenu et décider que ce contenu mérite d’intégrer mon second cerveau.
J’ai finalement créé une commande spécifique, ?curate. Une URL seule ne crée plus rien. La curation doit être explicitement demandée et son résultat arrive dans 00_inbox, où il peut encore être validé humainement.
Le contenu des notes a lui aussi demandé plusieurs itérations. Une génération unique avait tendance à produire des synthèses trop superficielles et pouvait perdre certains chiffres, dates ou ordres de grandeur importants. J’ai donc séparé la lecture analytique de la rédaction finale. Le pipeline extrait d’abord le contenu, l’analyse, construit ensuite la note, vérifie sa structure et son contenu, puis seulement l’écrit dans Obsidian. Après une curation réussie, l’index sémantique est également mis à jour de manière incrémentale.
Le même problème est apparu lorsque j’ai demandé à Curtis de faire émerger des idées à partir du vault. Le modèle savait très bien résumer les notes. Or je lui demandais autre chose : identifier des tensions, écarter les évidences et formuler des problématiques qui justifient une recherche complémentaire. Allonger le prompt n’a pas suffi. La fonction a donc été décomposée en quatre étapes : scan, challenge, formulate, validate.
En construisant un agent de veille, j’ai surtout appris à définir ce qu’il devait faire ou ne pas faire, plus la production de code devient facile, plus la conception se déplace vers les règles.
Renaud Joly
Le vibe coding m’a permis de tester rapidement ces différentes solutions. La fiabilité est venue ensuite, en transformant les problèmes observés en étapes, validations et permissions plus précises.
Les sources requièrent surtout du filtrage
Les 161 sources actives donnent facilement l’impression que Curtis est d’abord une machine de collecte. Son fonctionnement quotidien repose pourtant sur une série de limites.
Chaque matin, le pipeline travaille sur une fenêtre stricte correspondant à J-1. Une source fournit au maximum cinq articles. Un topic entraîne au plus cinq lectures et trois articles retenus. Un run complet est plafonné à 500 articles et vingt topics. Après déduplication et lecture, seuls les contenus obtenant au moins 7 sur 10 lors du scoring sont conservés dans le rapport Markdown envoyé sur Telegram.
Le scoring ne cherche pas seulement à identifier une nouveauté technique. Il privilégie les éléments qui m’intéressent au premier chef : les conséquences business, les usages, les changements de processus et les effets de second ordre. Curtis apprend aussi de deux catégories de feedback : les évaluations que je formule explicitement et mes décisions de curation. Une curation réussie produit un signal positif de 1.0 sur le contenu et un signal plus faible, 0.25, sur sa source. Cette différence évite de déduire de la qualité d’un article que l’ensemble du média mérite automatiquement davantage de poids.
Les limites protègent les ressources de la machine, mais leur fonction est aussi éditoriale. Une source très prolifique ne doit pas monopoliser la veille. Un topic large ne doit pas remplir à lui seul le rapport. Et le simple fait qu’un contenu soit disponible ne lui donne aucun droit particulier à arriver jusqu’à moi.
L’objectif n’était pas d’augmenter indéfiniment la quantité d’informations que je pouvais collecter. Il fallait réduire suffisamment le flux pour que la partie conservée redevienne exploitable.
Une note seule ne produit pas de connaissance
La sélection continue au moment de la mémorisation. Les articles retenus par la veille ne deviennent pas automatiquement des notes. La création d’une connaissance durable reste une décision utilisateur explicite.
Chaque note Obsidian produite par Curtis suit le même squelette :
RésuméÀ retenir (chiffres) Questions à creuserSourceRelated (liens)
Les quatre premières parties organisent le contenu de la note. La dernière remplit un autre rôle. Related contient des liens vers d’autres notes du vault.
C’est une partie importante de ce que j’essaie de construire. Une collection de résumés bien indexés reste essentiellement une collection de résumés. Elle devient plus intéressante lorsque les nouvelles informations commencent à se connecter à des connaissances déjà présentes.
Après une curation, Curtis peut donc rechercher des notes proches et enrichir la section Related. La commande ?link sert également à trouver ces proximités, tandis que ?cleanlink et ?refreshlink assurent la maintenance des liens cassés ou de leurs libellés.
La connaissance que je cherche à produire ne réside pas seulement dans le contenu d’une note. Elle apparaît aussi dans le graphe formé par ces relations. Un article sur les agents de paiement peut, par exemple, devenir intéressant parce qu’il se relie à une note antérieure sur la délégation, à une autre sur la fraude et à une troisième sur les nouvelles interfaces du commerce. Pris séparément, chacun de ces contenus apporte de l’information. Leur rapprochement peut faire apparaître une réflexion qui n’était explicitement formulée dans aucune des sources.
C’est aussi la logique derrière ?idees-articles. La skill ne travaille pas uniquement sur les contenus les plus récents. Elle constitue un corpus allant jusqu’à dix-huit notes, en combinant neuf notes des 90 derniers jours, cinq notes intermédiaires allant jusqu’à douze mois et quatre archives pertinentes. Elle cherche ensuite des tensions dans cet ensemble avant de formuler des problématiques.
On peut commencer à parle de second cerveau, lorsque la connaissance passée peut modifier la lecture d’une information nouvelle.
La recherche sémantique ne remplace pas ces liens
Mon index sémantique représente actuellement 105 notes sous forme de 159 fragments vectoriels. Il est reconstruit complètement chaque semaine et mis à jour après une curation réussie. Si l’index ou Ollama devient indisponible, Curtis peut revenir à une recherche purement lexicale.
Les embeddings permettent de retrouver une note même lorsque la question n’utilise pas exactement son vocabulaire. Ils servent donc très bien à la découverte et à la récupération.
Je ne les considère cependant pas comme un substitut aux liens Related. Un score de similarité dit que deux fragments se ressemblent dans l’espace vectoriel. Un lien conservé dans une note matérialise une relation qui fait désormais partie de mon corpus de connaissances.
Les deux couches répondent ainsi à des besoins différents : les vecteurs aident Curtis à retrouver ; les liens permettent au vault de conserver des relations.
Cette distinction explique aussi pourquoi je ne cherche pas à tout vectoriser puis à considérer le problème de la connaissance comme réglé. Retrouver de l’information est une fonction nécessaire du second cerveau. Construire progressivement une structure de connaissance entre les informations en est une autre.
Le choix du local ajoute ses propres contraintes
Curtis tourne sur un Mac mini M4 dédié équipé de 24 Go de mémoire unifiée et 500 Go de stockage. L’inférence passe par Ollama avec mistral-small3.2:latest en quantification Q4. Le contexte opérationnel est limité à 8 192 tokens, une valeur retenue après mesure pour permettre le chargement complet sur GPU sans swap.
Cette architecture locale impose de composer avec des ressources finies. Les demandes provenant de Hermes et Telegram sont placées dans une file FIFO. Un seul modèle local doit absorber des pipelines parfois longs, ce qui rend le parallélisme plus risqué qu’utile. La veille quotidienne bénéficie même d’une réservation Ollama afin qu’un autre traitement utilisant le même runtime ne vienne pas l’interrompre (j’ai d’autres projets en cours).
Une veille peut durer plusieurs minutes et parfois approcher une heure. Le timeout du flux local a été porté à 7 200 secondes afin de couvrir à la fois l’attente dans la file et les traitements les plus longs. Certaines skills disposent également de leurs propres timeouts plus élevés lorsque la génération demandée le nécessite.
J’ai donc accepté une latence qui serait difficilement défendable pour un chatbot grand public. Curtis travaille en grande partie en désynchronisé. Pour ces usages, je privilégie l’achèvement du traitement, la profondeur de lecture et la traçabilité plutôt qu’une réponse donnant immédiatement une impression de vitesse.
Le local échange certaines dépendances externes contre des contraintes de calcul, de contexte et de maintenance. Ce compromis me convient parce que le vault, les modèles et les traces d’exécution restent sur une machine dédiée.
29 commandes
L’inventaire contient aujourd’hui 29 commandes. Elles permettent d’interroger les notes, de curer un contenu, de maintenir les liens, de gérer les sources, de lancer une veille ou encore de chercher des problématiques éditoriales. Elles sont expliquées via une aide.
Ce compteur mesure assez bien l’accumulation fonctionnelle du projet 😉 mais moins bien son architecture. Ce qui détermine le comportement de Curtis est surtout la frontière entre ces capacités.
Les actions sont réparties entre quatre niveaux : read, draft, write_local et external. Le système n’offre pas au modèle un shell généraliste, l’accès à toutes les variables d’environnement ou la totalité du système de fichiers. Chaque skill possède un périmètre et des effets connus.
La mémoire elle-même est séparée en trois espaces. Obsidian contient les connaissances validées et durables. Curtis_Workspace reçoit les rapports, brouillons et documents de travail. La conversation récente et les artefacts temporaires restent dans une mémoire d’exécution en RAM. Cette séparation évite notamment qu’un fichier reçu ou qu’une discussion devienne automatiquement une connaissance permanente.
Cette architecture est probablement mon principal apprentissage en vibe-codant Curtis. La facilité à ajouter une capacité rend tentant d’en ajouter beaucoup. Construire un agent utilisable demande ensuite de déterminer quelles décisions peuvent rester probabilistes, quelles données doivent durer et quelles opérations doivent devenir des règles déterministes.
Ce que je veux mesurer maintenant
Curtis est parti d’un problème de surcharge informationnelle. Après plusieurs itérations, il collecte beaucoup, élimine davantage, puis me laisse décider ce qui mérite d’être transformé en connaissance durable.
La prochaine étape n’est donc pas d’ajouter encore quelques commandes. Je veux surtout affiner ce que produit la boucle complète : veille, sélection, curation, liens entre les notes, recherche dans le vault, nouvelles questions, puis retour de ces choix vers le système de veille.
Les mécanismes de feedback existent déjà. Une curation influence le contenu et, plus faiblement, sa source. Le graphe Related commence parallèlement à relier les nouvelles notes au fonds accumulé. Je n’ai cependant pas encore assez de recul pour mesurer sérieusement l’effet de ces deux boucles sur la qualité des résultats.
C’est cette mesure qui m’intéresse désormais : après plusieurs mois de sélections, de liens, de refus et de feedbacks, le système produit-il des rapprochements que je n’aurais pas faits seul et devient-il réellement meilleur pour identifier ce qui mérite mon attention ?