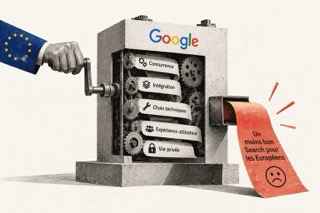
La communication de Google contre le Digital Markets Act mérite d’être examinée pour la manière dont elle présente son raisonnement.
Dans une interview reprise par Search Engine Roundtable, Nick Fox, Senior Vice President Knowledge & Information chez Google, explique que l’application du DMA aurait conduit à la « plus grande réduction de la qualité de Search » en vingt-huit ans. Il évoque un produit volontairement dégradé en Europe, un recul de la lutte contre le spam et surtout le risque d’une « massive violation » de la vie privée provoquée par le partage de données de recherche avec des concurrents.
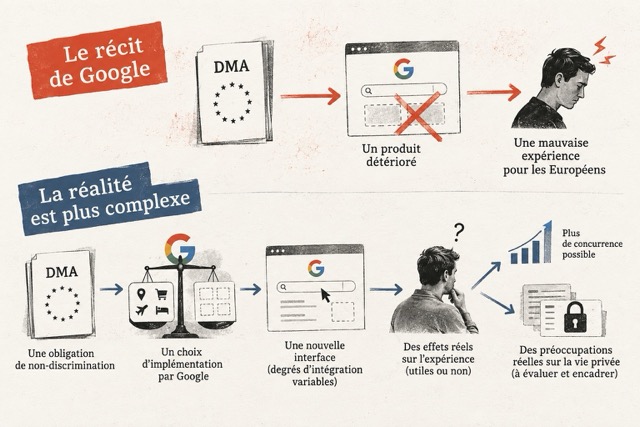
Pris un à un, les sujets existent. Un biais apparaît cependant dans la façon dont ces éléments sont assemblés. Google transforme plusieurs controverses distinctes en une chaîne causale simple : le DMA contraint Google, Google doit détériorer son produit, les Européens en subissent les conséquences.
Cette démonstration repose sur plusieurs manoeuvres rhétoriques.
1. Le faux dilemme : concurrence ou qualité
La formule de Nick Fox résume assez bien le premier procédé : « Competition shouldn’t come at the cost of privacy or a worse experience. »
La phrase semble difficilement contestable. Personne ne souhaite sacrifier la vie privée ou la qualité pour obtenir davantage de concurrence. Le problème est qu’elle construit une alternative qui n’est pas celle du DMA.
Le raisonnement implicite devient :
- soit Google conserve ses intégrations actuelles et fournit le meilleur produit possible
- soit la réglementation impose davantage de concurrence et l’expérience se détériore
C’est un faux dilemme. Une troisième possibilité existe : certaines intégrations peuvent améliorer l’expérience utilisateur tout en restant ouvertes à la concurrence.
C’est précisément le problème de l’auto-préférence. En juillet 2026, la Commission européenne a estimé que Google continuait à favoriser ses propres services de shopping, d’hôtels, de transport ou de sport dans Search, notamment par leur position, leur présentation et des filtres auxquels des services concurrents n’avaient pas accès.
Le bon raisonnement consiste donc à déterminer quel niveau d’intégration améliore réellement le service et à partir de quel point cette intégration devient un abus de position dominante.
La formulation de Google supprime cette zone intermédiaire. C’est précisément ce qui la rend fausse.
2. L’homme de paille : « Bruxelles nous oblige à dégrader Search »
Nick Fox donne plusieurs exemples très concrets : impossibilité d’accéder aussi directement à Maps, disparition de certaines informations tarifaires, limitation de filtres ou de fonctions auparavant intégrées à Search. Google présente leur suppression comme une conséquence du DMA. La formulation reconstruit pourtant la position du régulateur.
La règle européenne ne dit pas : « rendez Google Maps moins pratique ». Elle impose seulement à Google de ne pas traiter ses propres services plus favorablement que les services concurrents.
Ce qui disparaît entre les deux propositions est le choix d’implémentation de Google.
Google peut parfaitement soutenir qu’aucune autre solution réaliste ne permettait de satisfaire la contrainte sans détériorer le produit. Mais c’est alors cette impossibilité qu’il faut démontrer.
En la faisant disparaître, le discours attribue directement au législateur le résultat de l’interface :
obligation de non-discrimination → suppression d’une fonctionnalité → Bruxelles a supprimé la fonctionnalité.
Le procédé ressemble à un homme de paille institutionnel : la règle réellement contestée est remplacée par une version beaucoup plus facile à attaquer : « l’Europe nous demande de fabriquer un moins bon moteur de recherche ». Or ce n’est pas le cas.
3. Le post hoc causal : après le DMA, donc à cause du DMA
On retrouve ici une confusion causale classique. Google a modifié Search pour se conformer au DMA. Certaines de ces modifications créent de la friction. La friction est alors présentée comme un effet du DMA.
Mais plusieurs causalités se superposent :
DMA → obligation juridique → arbitrage technique de Google → nouvelle interface → comportement de l’utilisateur.
La communication compresse la chaîne :
DMA → mauvaise expérience.
Cette compression permet d’évacuer toutes les variables intermédiaires. Le point n’est pas de nier la causalité réglementaire initiale. Sans DMA, Google n’aurait probablement pas effectué certaines modifications. Mais « cette règle oblige Google à modifier son produit » ne signifie pas automatiquement « cette règle imposait précisément cette dégradation ».
Dans une analyse sérieuse, il faudrait comparer plusieurs scénarios de conformité et établir que la perte constatée était difficilement évitable. Sinon, Google impute au texte réglementaire ce qui relève en partie de ses propres arbitrages d’optimisation.
4. La pente glissante du partage de données au piratage des recherches intimes
Le passage sur la vie privée constitue le cas le plus net.
Nick Fox part d’un fait solide : les recherches Google peuvent contenir des informations extrêmement sensibles sur la santé, les finances ou la vie personnelle. Il poursuit en expliquant que ces données vont sortir des infrastructures sécurisées de Google, être transmises à des tiers puis devenir vulnérables au piratage et aux abus.
La chaîne paraît naturelle :
données partagées → davantage de détenteurs → surface de risque accrue → piratage → exposition de recherches intimes.
Le sophisme apparaît lorsqu’une chaîne de possibilités est présentée comme si elle établissait la conséquence finale.
Le dispositif arrêté en juillet 2026 ne prévoit pas simplement la remise de requêtes brutes à « n’importe quelle entreprise ». L’article 6(11) porte sur des données anonymisées destinées à des moteurs éligibles. La décision de la Commission prévoit une méthode d’anonymisation à plusieurs niveaux et autorise Google à évaluer préalablement certains risques graves de cybersécurité ou de protection des données liés au destinataire.
Cela ne démontre pas que le système est sûr. Google peut avoir raison de considérer l’anonymisation insuffisante. Mais pour établir son argument, il faudrait mesurer le risque résiduel : probabilité de réidentification, vulnérabilités introduites, population exposée, scénarios d’attaque plausibles.
Google ne met en avant que la gravité maximale du scénario. C’est une technique classique de communication du risque : faire sentir la pire conséquence avant d’en établir la probabilité.
5. L’appel à la peur : « les questions que vous ne posez même pas à votre conjoint »
Nous sommes ici en présence d’un appel émotionnel fort. Nick Fox ne parle pas simplement de données de recherche. Il rappelle que Google reçoit les questions que les utilisateurs ne poseraient « ni à leur conjoint, ni à leurs amis, ni à leur médecin ».
La discussion quitte le terrain relativement abstrait des conditions d’anonymisation pour faire surgir l’image de secrets médicaux, financiers ou familiaux exposés à des inconnus. Cette concrétisation n’est pas illégitime. Elle illustre correctement la sensibilité potentielle des données.
Mais elle produit aussi un effet de substitution : l’émotion associée à la donnée brute prend la place de l’évaluation du mécanisme réellement prévu pour la protéger.
Pour démonter l’argument, il ne faut surtout pas répondre que la confidentialité ne pose aucun problème. Il faut ramener la discussion vers les variables absentes :
- quelles données exactes sont transmises
- après quelle anonymisation
- avec quelle possibilité de réidentification
- à quels acteurs
- sous quelles contraintes
- avec quel risque supplémentaire par rapport à la concentration actuelle des données chez Google
L’appel à la peur perd beaucoup de son efficacité dès que le débat revient sur une architecture de risque.
6. Le cadrage trompeur : Google victime = l’utilisateur européen victime
Nick Fox explique également se sentir « terrible » et « sad » de devoir dégrader Search pour les Européens. Google conclut que les Européens « deserve the best ». Ce registre produit un cadrage trompeur particulièrement efficace : Google n’est plus l’entreprise régulée. Il devient le représentant de l’utilisateur face au régulateur.
Le conflit est ainsi redistribué : Google + utilisateurs européens contre réglementation européenne.
Or le DMA intervient précisément parce que Google n’est pas considéré comme un simple fournisseur quelconque, mais comme un gatekeeper dont les décisions peuvent affecter l’accès d’autres entreprises au marché. La Commission a d’ailleurs conclu en juillet 2026 que Google accordait encore un traitement préférentiel à plusieurs de ses propres services dans Search.
Le cadrage émotionnel efface donc un intérêt matériel évident : certaines dispositions du DMA limitent directement la capacité de Google à exploiter les avantages produits par son intégration verticale. Cela ne rend pas l’entreprise automatiquement coupable ni ses arguments faux. Cela rend simplement trompeuse la présentation d’un Google parlant depuis une position identique à celle de ses utilisateurs.
7. Le déplacement du but : « les bénéficiaires ne sont même pas européens »
Nick Fox avance ensuite que les entreprises susceptibles de recevoir ces données ne sont généralement pas européennes et que le dispositif ne favoriserait donc pas réellement la concurrence européenne. Ce raisonnement déplace le critère d’évaluation.
Le DMA ne vise pas principalement à produire des concurrents dont le capital serait européen. Il cherche à rendre les marchés numériques européens plus concurrentiels.
La Commission justifie notamment l’accès aux données de Search par un mécanisme cumulatif : la position de Google lui fournit une quantité de données incomparable, ces données améliorent le moteur, l’amélioration attire davantage d’utilisateurs, qui génèrent à leur tour davantage de données.
Pour réfuter cette politique, il faudrait donc montrer que l’accès aux données ne réduit pas cette barrière à l’entrée ou qu’il crée des coûts supérieurs à son bénéfice concurrentiel.
Constater que certains bénéficiaires sont américains répond à une autre question. C’est un déplacement du but : on passe de « davantage de concurrence en Europe » à « davantage d’entreprises européennes », puis on critique le dispositif selon ce nouveau critère.
8. Le sophisme de l’autorité propriétaire : « nos données disent que »
La formule « biggest reduction in search quality in 28 years » constitue enfin une forme particulière d’argument d’autorité.
Google possède effectivement une expertise et des données qu’aucun observateur extérieur ne peut égaler sur le fonctionnement de Search. Cela rend son témoignage important ; mais en aucun cas auto-validant.
Que signifie ici « qualité » ? Quelle métrique est utilisée ? Sur quelles familles de requêtes ? Quelle amplitude est observée ? Quelle méthodologie compare l’Europe au reste du monde ?
L’interlocuteur ne fournit pas ces éléments. L’affirmation exploite donc une asymétrie informationnelle assez remarquable : Google est l’acteur le mieux placé pour produire la preuve et, pour la même raison, l’un des seuls acteurs capables de l’auditer complètement.
Le statut de Google devient alors indirectement la preuve de Google. Le bon réflexe face à ce type d’affirmation tient en quatre questions : quelle métrique, quel protocole, quelle amplitude, quelles données vérifiables ?
Sans elles, « la plus forte baisse en vingt-huit ans » est une affirmation spectaculaire, pas une mesure reproductible (donc pas vérifiable).
9. L’amalgame : qualité, spam, confidentialité et concurrence dans un même paquet
Pris ensemble, les arguments de Nick Fox produisent enfin un effet de mille-feuille. Maps, prix en temps réel, hôtels, spam, données personnelles, piratage, nationalité des concurrents : chaque sujet possède son propre mécanisme, ses propres preuves et ses propres arbitrages. La communication les agrège pourtant sous un message unique :
le DMA détériore Google Search pour les Européens.
C’est probablement le procédé le plus important. Car pour réfuter le récit, il faut déplier séparément chaque couche. Une mauvaise règle concernant le spam ne démontre rien sur le partage de données. Une friction liée à Maps ne démontre rien sur l’efficacité concurrentielle de l’article 6(11). Un risque de réidentification ne prouve pas que l’auto-préférence doit être autorisée.
L’accumulation donne l’impression d’un faisceau de preuves convergentes alors qu’elle rassemble surtout plusieurs litiges indépendants les uns des autres. La quantité masque progressivement la qualité.
Le recadrage consiste à rétablir les questions supprimées
La communication n’a pas besoin d’être mensongère pour être biaisée. Elle fonctionne mieux en partant de faits réels, puis en modifiant leur cadre.
Une friction devient une dégradation imposée. Une obligation devient une décision d’interface de Bruxelles. Un risque devient une catastrophe plausible. Une donnée interne devient une preuve par le statut de celui qui la détient. Plusieurs controverses distinctes deviennent finalement la démonstration que le DMA nuit aux Européens.
Pour sortir de cette construction, il suffit souvent de réintroduire les étapes intermédiaires : Quelle disposition précise produit quel effet ? Quelles autres implémentations étaient possibles ? Quelle est la probabilité du risque annoncé ? Quelle métrique mesure la dégradation ? Quel objectif réglementaire est réellement évalué ?
Ces questions ne donnent pas automatiquement raison à la Commission. Elles empêchent simplement Google de choisir simultanément le problème, les critères d’évaluation (Intégration des services Google ? Abus de position dominante ?) et la conclusion. Et c’est souvent le point le plus intéressant en matière de communication : décider de quoi le débat doit parler.