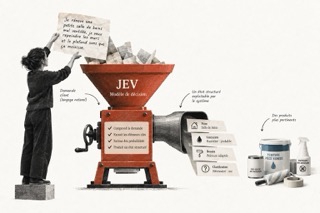
Cet article est prospectif. Le modèle JEV a été présenté par TypeSafe AI le 14 septembre 2026 et n’est disponible que depuis quelques jours. Les architectures et exemples sont basés sur des problématiques bien réelles mais l’apport de JEV reste une hypothèse.
Un client qui tape « peinture blanche satinée 10 L » facilite le travail du moteur de recherche. Il donne presque directement une catégorie, une couleur, une finition et un conditionnement. Entre sa demande et le catalogue, la traduction est courte.
« Peinture pour salle de bains humide » demande déjà davantage d’interprétation. La pièce et l’humidité deviennent des contraintes. Le moteur doit comprendre que le client ne cherche pas simplement une peinture intérieure, mais un produit compatible avec un environnement particulier.
Puis arrive : « je rénove une petite salle de bains mal ventilée, je veux repeindre les murs et le plafond sans que ça moisisse ». Aie !
La catégorie produit a disparu de la demande. Le client décrit un projet, un problème et un résultat attendu. Pour bien répondre, il faudrait éventuellement identifier le support, distinguer humidité persistante et ancienne moisissure, sélectionner une peinture adaptée, déterminer si une sous-couche ou un traitement sont nécessaires et calculer une quantité. Plusieurs produits peuvent participer à la réponse.
C’est dans cet écart entre l’intention du client et la structure du catalogue que JEV pourrait devenir intéressant.
Pas parce que les moteurs de recherche e-commerce ne comprennent aujourd’hui rien aux requêtes. C’est évidemment faux. Les systèmes modernes combinent recherche lexicale, analyse sémantique, attributs, filtres, signaux comportementaux et learning-to-rank. Amazon documentait déjà en 2022 l’utilisation de modèles de compréhension des requêtes pour extraire ou recommander des attributs, utilisés ensuite dans le ranking, la recommandation ou la publicité.
La question est plus étroite : JEV peut-il améliorer cette compréhension suffisamment pour justifier une nouvelle couche dans l’architecture ?
JEV ne cherche pas à parler au client
JEV appartient à une catégorie de modèles que TypeSafe AI appelle « System One Models ». La différence avec un LLM conversationnel est assez nette.
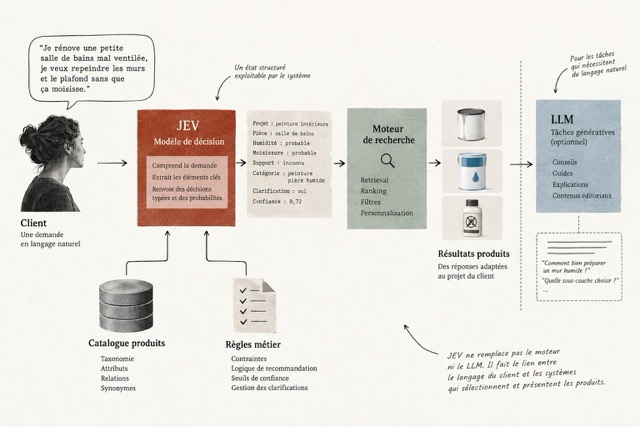
On lui fournit un état, par exemple la requête du client, puis des questions dont les réponses possibles ont été définies à l’avance. Le modèle renvoie des décisions typées, des scores et des probabilités plutôt qu’une réponse en langage naturel. TypeSafe résume ce fonctionnement comme une transformation d’un état non structuré en décisions probabilistes typées.
Pour notre salle de bains, on pourrait donc interroger le modèle sur plusieurs dimensions :
Demande :
"Je veux repeindre les murs de ma salle de bains.
La pièce est humide et il y a quelques traces noires."

Projet :
peinture intérieure

Pièce :
salle de bains

Problème d'humidité :
probable

Présence de moisissure :
probable

Support :
inconnu

Catégorie candidate :
peinture pièce humide
peinture anti-humidité
traitement anti-moisissure
autre

Clarification nécessaire :
oui / non
L’intérêt n’est pas que JEV trouve un joli nom pour le problème. C’est que le logiciel récupère un état structuré dont chaque élément peut déclencher une action.
La catégorie candidate peut alimenter le retrieval. La pièce peut activer certains attributs. L’humidité peut modifier le ranking des produits. L’absence d’information sur le support peut empêcher une recommandation trop précise. Une faible confiance peut provoquer une question supplémentaire.
Cette position dans l’architecture est importante : JEV ne remplacerait pas le moteur de recherche. Il lui fournirait une interprétation exploitable de la demande.
Projeter la demande sur la taxonomie est le premier test, pas la finalité
Prenons une taxonomie simplifiée :
Fixation
└── Chevilles
    ├── Chevilles universelles
    ├── Chevilles pour matériaux pleins
    ├── Chevilles pour matériaux creux
    └── Chevilles métalliques pour plaques de plâtre
La requête « chevilles Molly 8 mm » ne justifie probablement pas beaucoup d’intelligence supplémentaire. Un bon moteur lexical, des synonymes et un extracteur d’attributs peuvent déjà obtenir d’excellents résultats.
Avec « cheville pour fixer une télé sur du placo », la situation change. Le client fournit un usage, un support et implicitement une contrainte de charge. Il ne connaît pas forcément le nom du produit (c’est un exemple fréquent en bricolage).
JEV pourrait transformer la demande en quelque chose comme :
support = plaque de plâtre
objet = téléviseur
charge = importante
famille probable = fixation pour matériau creux
Le catalogue retrouve alors son terrain de jeu habituel.
Ce cas est assez favorable parce que la relation entre besoin et famille de produits reste relativement directe. L’utilisateur ignore le nom du produit, mais sa demande peut encore être projetée sur une branche du catalogue.
« Je veux isoler un mur froid dans mon garage » pose un problème différent.
Faut-il proposer des panneaux isolants ? Un doublage ? Une solution contre l’humidité ? Impossible de répondre correctement sans connaître davantage le mur, la place disponible, l’humidité éventuelle ou le type de pose envisagé.
Une classification forcée serait alors une erreur de conception. Le modèle devrait pouvoir produire une étape intermédiaire qui revient à dire : plusieurs catégories sont plausibles et l’information disponible ne permet pas encore de choisir.
C’est là que les probabilités annoncées par JEV deviennent potentiellement utiles. Non parce qu’un score à deux décimales rendrait magiquement la décision scientifique, mais parce qu’une architecture peut traiter différemment une décision à forte confiance et une hypothèse fragile.
Avec une confiance élevée, la catégorie peut devenir un filtre. Avec une confiance intermédiaire, elle peut servir de boost. Avec une confiance faible ou plusieurs catégories proches, le moteur peut élargir la recherche ou demander une précision.
L’incertitude cesse alors d’être uniquement une faiblesse du modèle. Elle devient une variable du parcours.
Une taxonomie produit décrit des produits, pas nécessairement des intentions
Considérons : « je veux repeindre ma chambre bleu foncé en beige ».
La taxonomie sait probablement classer peintures intérieures, sous-couches, rouleaux, rubans de masquage et bâches. Elle ne contient pas forcément un objet appelé « passer d’un mur bleu foncé à un mur beige ».
Pourtant, c’est précisément ce que veut faire le client. La compréhension pourrait nécessiter une représentation intermédiaire :
Projet
↓
Contraintes et état du chantier
↓
Besoins fonctionnels
↓
Catégories et attributs produits
Dans notre exemple :
Projet :
repeindre une chambre

État :
mur déjà peint
couleur actuelle foncée

Objectif :
couleur finale claire

Informations manquantes :
nature et état du support
surface

Besoins produits possibles :
préparation
sous-couche
peinture de finition
protection
matériel d'application
La différence n’est pas purement sémantique.
Si l’on projette immédiatement la requête sur « peinture intérieure beige », le moteur peut trouver de très bonnes peintures et pourtant donner une réponse médiocre au projet. La question de la sous-couche ou de la préparation étant négligée.
Un classifieur parfait appliqué à une représentation trop pauvre restera parfaitement limité.
Pour le bricolage, l’enjeu pourrait donc être moins de connecter JEV à la seule taxonomie que de créer une petite ontologie des projets, supports, contraintes et opérations, elle-même reliée au catalogue.
Le catalogue continue à dire ce que l’entreprise vend. L’ontologie décrit ce que le client essaie de faire.
Comprendre ne sert à rien si le retrieval ne suit pas
Supposons maintenant que le système comprenne :
projet = repeindre salle de bains
support = mur intérieur
humidité = élevée
finition souhaitée = satinée
surface = 20 m²
Il faut encore transformer cette compréhension en résultats.
Une première architecture pourrait conserver les moteurs existants et utiliser les décisions de JEV comme signaux :
Requête en langage naturel
           ↓
          JEV
           ↓
catégories / attributs / contraintes
           ↓
 ┌─────────────────────────┐
 │ recherche lexicale      │
 │ recherche sémantique    │
 │ filtres catalogue       │
 └─────────────────────────┘
           ↓
     produits candidats
Tous les signaux n’ont pas besoin d’avoir le même statut.
Si le client demande explicitement « peinture blanche », la couleur peut devenir une contrainte forte. Si le modèle déduit seulement qu’une peinture anti-humidité serait pertinente, cette information peut devenir un boost plutôt qu’un filtre. C’est ce que fait un bon vendeur.
Cette différence est importante. Le risque d’un système de compréhension n’est pas seulement de ne pas comprendre. Il peut aussi comprendre avec beaucoup d’assurance quelque chose que le client n’a jamais demandé, puis éliminer les bons produits en amont.
Une architecture robuste doit donc traduire non seulement les décisions du modèle, mais également leur niveau de certitude en comportements différents du moteur.
Le reranking est peut-être un terrain plus naturel
Une autre possibilité consiste à laisser les systèmes actuels générer les candidats, puis à utiliser JEV pour les départager.
Prenons : « peinture blanche pour plafond de salle de bains qui résiste bien à l’humidité »
Le moteur récupère 100 produits plausibles. Le ranking existant combine déjà des signaux de pertinence textuelle, disponibilité, popularité, conversion, prix, préférences de marque ou contexte utilisateur.
On peut ensuite demander au modèle de juger, pour chaque candidat :
Le produit convient-il à un plafond ?
Est-il conçu pour une pièce humide ?
Répond-il au besoin exprimé ?
Existe-t-il une incompatibilité manifeste ?
Ce principe n’est pas nouveau. L’idée d’extraire une représentation plus structurée d’une requête puis de l’utiliser dans le ranking est déjà bien documentée.
Un travail d’Amazon présenté à AACL 2025 utilise par exemple un LLM pour transformer certains besoins implicites en « hints » structurés intégrés au pipeline de ranking. Sur le benchmark utilisé par les chercheurs, leur méthode améliore le MAP de 10,9 points et le MRR de 5,9 points par rapport à leurs baselines. Ils soulignent en parallèle qu’un reranking effectué directement par un LLM générique introduit une latence trop élevée, ce qui les conduit à transférer cette interprétation vers des modèles plus légers.
Un autre travail Amazon présenté à SIGIR 2026 construit des représentations structurées des produits à partir de leurs attributs. Les expériences rapportées obtiennent plus de 5 % d’amélioration de précision moyenne tout en réduisant de 57 % le volume de tokens par produit par rapport à une approche travaillant davantage sur le texte brut.
Ces travaux ne valident pas JEV. Ils valident plutôt le problème auquel il prétend apporter une nouvelle solution : une représentation structurée du besoin et des produits peut améliorer le ranking sans demander à un LLM frontière de relire intégralement chaque résultat à chaque requête.
Et nous disposons déjà d’un premier signal spécifique à JEV. Le 18 septembre, Parallel a publié un test indépendant dans lequel le modèle est utilisé comme reranker de résultats de recherche. Sur leur jeu de données interne, JEV atteint un NDCG@10 de 0,7 et rejoint au moins l’un de leurs rerankers spécialisés. Parallel note toutefois que son coût par document reste supérieur à celui de leurs propres modèles, dont ils maîtrisent l’infrastructure d’inférence.
C’est encourageant. Trois jours de recul constituent cependant une base assez mince pour revoir l’architecture d’un site marchand. 😇
Les catégories voisines sont le test qui compte vraiment
La classification devient beaucoup plus intéressante lorsque les frontières du catalogue ressemblent à celles-ci :
Peinture intérieure
├── murs et plafonds
├── cuisine et salle de bains
├── anti-humidité
├── anti-moisissures
├── sous-couches
└── peintures de rénovation
Que signifie exactement « peinture pour mur humide dans ma salle de bains » ?
La réponse peut dépendre de la cause de l’humidité et de l’état du mur. Plusieurs catégories peuvent sembler sémantiquement correctes sans être fonctionnellement interchangeables.
Or Parallel rapporte précisément une limite intéressante : sur une tâche de classification comportant un grand nombre de labels, leurs modèles spécialisés ont mieux performé que JEV. Les auteurs considèrent la taille de l’espace de labels comme une faiblesse observée dans leur test.
C’est un avertissement utile pour le bricolage, où une taxonomie peut comporter des centaines ou des milliers de feuilles.
Le mauvais benchmark consisterait probablement à transmettre toute la taxonomie à JEV et à lui demander de trouver directement la feuille parfaite. Une approche hiérarchique semble plus crédible :
Univers
→ famille
→ sous-famille
→ attributs
Une autre consisterait à laisser un moteur lexical ou vectoriel identifier vingt catégories candidates, puis à demander au modèle de départager cet espace réduit.
L’intérêt de JEV serait alors moins celui d’un GPS omniscient du catalogue que celui d’un aiguillage entre quelques chemins déjà plausibles. C’est moins spectaculaire. C’est aussi beaucoup plus proche d’une architecture exploitable.
Face à JEV, les alternatives sont déjà solides
Pour mesurer sa valeur, il faut éviter une comparaison commode : JEV contre une recherche par mots-clés sans compréhension sémantique.
Une direction e-commerce dispose aujourd’hui d’au moins quatre autres options.
Le moteur existant peut combiner règles, synonymes, analyse de requête, lexical search, embeddings, signaux comportementaux et learning-to-rank. Une entreprise disposant de suffisamment de données peut également entraîner des classifieurs spécialisés pour les catégories ou les attributs. C’est moins flexible, mais potentiellement très rapide et très performant sur un domaine stable.
Un LLM peut de son côté produire directement un JSON décrivant projet, catégorie, attributs et informations manquantes. Il dispose en plus de capacités conversationnelles lorsque le besoin sort de ce cadre.
JEV propose un autre compromis : conserver le langage naturel en entrée, mais limiter la sortie à des décisions préalablement définies.
Sa valeur ne pourra donc pas être établie en montrant qu’il classe correctement cent requêtes. Il faudra démontrer qu’il fait mieux, moins cher ou plus simplement qu’une combinaison déjà disponible de règles, modèles spécialisés et LLM.
Le test de Parallel illustre bien cette tension. JEV atteint une qualité compétitive sans entraînement spécifique sur leur tâche de reranking, ce qui réduit potentiellement le coût de développement initial. Mais leurs classifieurs spécialisés restent meilleurs sur d’autres tâches et peuvent être moins chers à grande échelle.
Le « zéro-shot » est une qualité d’industrialisation. Ce n’est pas automatiquement une qualité de résultat.
Le coût change sérieusement l’équation face à un LLM
Il existe cependant une différence entre JEV et un LLM généraliste qui mérite davantage qu’une ligne dans un tableau : le prix de l’inférence.
TypeSafe affiche actuellement JEV à 0,042 dollar par million de tokens d’entrée, soit 42 dollars par milliard de tokens, et indique que les sorties ne sont pas facturées. L’explication tient en partie à l’architecture : JEV ne génère pas séquentiellement une réponse textuelle token après token ; il calcule en parallèle des décisions appartenant à un espace défini à l’avance.
À titre de comparaison, les tarifs API publiés en septembre 2026 sont de 4 dollars par million de tokens d’entrée et 20 dollars en sortie pour GPT-5.6 Sol, et de 2 dollars en entrée et 10 dollars en sortie pour Claude Sonnet 5.
Sur le seul token d’entrée, JEV est donc environ 95 fois moins cher que GPT-5.6 Sol et 48 fois moins cher que Claude Sonnet 5.
L’écart réel par requête peut être supérieur parce que le LLM facture également sa sortie.
Prenons un exemple volontairement simple, non comme benchmark mais comme ordre de grandeur. Supposons qu’une étape de compréhension consomme 500 tokens d’entrée et qu’un LLM génère ensuite 50 tokens de JSON structuré.
Pour un million de requêtes :
JEV
500 M tokens d'entrée × 0,042 $ / MTok
≈ 21 $

Claude Sonnet 5
500 M tokens d'entrée × 2 $ / MTok
+ 50 M tokens de sortie × 10 $ / MTok
≈ 1 500 $

GPT-5.6 Sol
500 M tokens d'entrée × 4 $ / MTok
+ 50 M tokens de sortie × 20 $ / MTok
≈ 3 000 $
Dans ce scénario simplifié, JEV coûterait environ 70 fois moins que Sonnet 5 et 140 fois moins que GPT-5.6 Sol sur cette étape de décision.
À l’échelle de quelques milliers de recherches, cette différence ne change pas grand-chose. À l’échelle de dizaines ou centaines de millions de recherches, de scores produits ou de décisions d’agents, elle change la nature des architectures envisageables.
Un reranking illustre encore mieux le problème. Si l’on doit évaluer 50 produits pour chaque requête, appeler un LLM généraliste 50 fois n’est pas seulement une question de latence. Même des micro-coûts deviennent rapidement une ligne budgétaire significative. Un modèle beaucoup moins cher permet théoriquement de placer davantage de décisions sémantiques à l’intérieur de la chaîne sans réserver l’IA aux seules requêtes à forte valeur.
C’est probablement l’un des arguments économiques les plus solides en faveur de JEV. Avec une réserve importante.
La comparaison avec un LLM « frontier » est favorable à JEV, mais elle n’épuise pas les alternatives. OpenAI propose une gamme de modèles dont les tarifs peuvent varier fortement, tandis que des modèles légers, des modèles open source servis en interne ou des classifieurs spécialisés peuvent réduire fortement l’écart.
Il serait donc trompeur de résumer le choix à :
JEV = 100× moins cher
LLM = 100× plus cher
Le vrai benchmark doit comparer le coût par décision correcte, dans les conditions réelles du pipeline.
Un modèle dix fois plus cher qui produit nettement moins d’erreurs peut être économiquement préférable. Un classifieur spécialisé entraîné sur des millions de requêtes peut coûter moins cher encore. À l’inverse, un modèle généraliste peut être inutilement coûteux lorsqu’on lui demande uniquement de choisir entre cinq catégories et de produire trois probabilités.
C’est précisément là que JEV défend une proposition différente : ne pas payer les capacités génératives d’un LLM lorsqu’on n’a besoin que d’une décision.
Le faible coût peut modifier l’architecture, pas seulement la facture
Cette différence mérite d’être poussée un peu plus loin.
Avec un LLM relativement coûteux, l’architecture cherche naturellement à réduire les appels. On appelle le modèle uniquement pour les requêtes complexes, on limite le nombre de produits rerankés ou on mutualise plusieurs décisions dans un gros prompt.
Lorsque la décision devient très peu coûteuse, d’autres architectures deviennent possibles. Un parcours « peinture salle de bains » pourrait successivement évaluer :
La requête exprime-t-elle un projet ?
Le support est-il identifiable ?
Un problème d'humidité est-il mentionné ?
Une clarification est-elle nécessaire ?
Quelles catégories doivent être recherchées ?
Chaque produit récupéré répond-il aux contraintes ?
Le résultat est-il assez pertinent pour être affiché ?
Faut-il déclencher un agent spécialisé ?
Avec un LLM généraliste, huit décisions peuvent inciter à fabriquer un prompt complexe qui tente de tout faire en un seul appel.
Avec des décisions très peu coûteuses, on peut préférer plusieurs étapes explicites, observables et testables séparément.
La différence est subtile mais importante. Le prix de l’inférence ne réduit pas seulement la facture du même système. Il peut rendre économiquement viable une architecture plus granulaire.
TypeSafe pousse fortement cet argument et publie sur ses propres workflows des écarts atteignant 444,6× en coût et 193,6× en vitesse face aux références choisies. L’entreprise précise elle-même que ces chiffres se situent probablement dans la partie haute des gains que l’on peut attendre en pratique et que ses évaluations sont réalisées par sa propre équipe. Ils doivent donc être considérés comme des résultats éditeur à reproduire, pas comme une propriété générale de JEV.
Le prix affiché, en revanche, est directement testable.
Pour une direction e-commerce, cela suggère un indicateur supplémentaire : combien coûte l’amélioration d’un point de NDCG, d’un point de conversion search ou d’une requête correctement résolue ?
Le coût du modèle devient alors comparable au gain commercial, pas simplement au prix d’un autre modèle.
JEV et le LLM ont probablement des rôles différents
Considérons une autre requête : « Mon ancienne peinture s’écaille après une fuite qui est maintenant réparée. Je peux repeindre directement ? »
Une catégorie ne suffit plus. Le système peut avoir besoin de comprendre si le support est sec, si les parties non adhérentes ont été retirées, quelle est la nature du mur et ce qui provoquait les dégradations.
Un LLM est naturellement adapté à l’explication et au dialogue. JEV pourrait intervenir ailleurs :
problème identifié ?
information critique manquante ?
question complémentaire nécessaire ?
recherche catalogue pertinente maintenant ?
agent peinture requis ?
risque d'une recommandation prématurée ?
La séparation devient intéressante.
Le LLM explique, reformule et dialogue. JEV prend des décisions répétitives dans un espace connu. Le moteur de recherche retrouve les produits. Les règles métier empêchent certaines recommandations ou imposent certains contrôles.
Cette architecture a aussi une logique économique : réserver les tokens génératifs coûteux aux moments où la génération apporte réellement quelque chose.
Si JEV peut qualifier dix étapes pour quelques fractions du coût d’un appel LLM, l’agent peut utiliser le LLM pour la conversation finale plutôt que pour chacune des décisions internes.
Cela ne garantit évidemment pas que l’ensemble sera moins cher. Ajouter JEV signifie aussi une intégration, du monitoring, des tests, une gestion des versions et une dépendance supplémentaire. Pour de faibles volumes, ces coûts fixes peuvent largement dépasser l’économie de tokens. À grande échelle, l’arbitrage change.
Du search à l’agent travaux
C’est ici que JEV pourrait devenir plus intéressant qu’un simple classifieur de requêtes.
Imaginons : « Je veux poser du parquet dans une chambre de 15 m² actuellement carrelée. »
Un moteur de recherche peut essayer de retrouver du parquet.
Un assistant travaux doit comprendre davantage : type de pose envisagé, compatibilité avec le support, sous-couche éventuelle, surface à commander avec marge, plinthes, seuils et outillage.
On pourrait imaginer une architecture dans laquelle JEV produit un état partagé :
projet = pose de parquet
pièce = chambre
surface = 15 m²
support actuel = carrelage
type de parquet = inconnu
méthode de pose = inconnue
clarification nécessaire = oui
agent spécialisé = revêtement de sol
Cet état peut être utilisé simultanément par le search, un calculateur de quantité, un moteur de règles et un agent spécialisé.
Même logique pour : « Je refais une terrasse en bois de 25 m². »
La taxonomie seule éclate immédiatement le problème entre lames, lambourdes, plots, visserie, produits de protection et outils. L’agent, lui, commence par le projet.
C’est ici que la perspective change : la taxonomie produit devient une ressource interrogée par un système de résolution du besoin, plutôt que la structure dans laquelle le client doit implicitement traduire son problème.
JEV pourrait être le moteur de certaines décisions de cette couche d’orchestration : quel agent appeler, quelles informations rechercher, quel outil utiliser, faut-il demander une précision, peut-on déjà interroger le catalogue ?
Le prix devient alors particulièrement pertinent. Un agent ne réalise pas une seule inférence par conversation. Il enchaîne potentiellement des dizaines de décisions internes. Si chacune nécessite un appel à un LLM généraliste, le coût augmente avec la profondeur du workflow. Si une partie de ces décisions peut être transférée vers un modèle spécialisé beaucoup moins cher, l’économie est importante.
C’est peut-être là que JEV dispose de son meilleur argument : pas nécessairement remplacer un appel LLM visible par l’utilisateur, mais supprimer une partie des appels LLM invisibles qui font fonctionner l’agent.
L’explicabilité est réelle, mais limitée
Une architecture structurée possède un avantage appréciable pour les équipes search.
Au lieu d’observer seulement qu’un produit est arrivé en troisième position, il devient possible de journaliser :
projet = peinture salle de bains
pièce humide = 0,94
support connu = 0,21
catégorie peinture pièce humide = 0,82
traitement préalable pertinent = 0,61
clarification requise = 0,76
On peut analyser ces décisions, comparer les versions du modèle et mesurer leur relation avec les comportements des utilisateurs. Ce niveau d’observation est utile.
Il ne faut cependant pas appeler cela une explication complète. Une probabilité dit ce que le modèle privilégie, pas pourquoi cette interprétation est correcte.
L’explicabilité vient surtout de la décomposition du problème choisie par l’entreprise : support, usage, pièce, humidité, catégorie, risque, clarification. JEV remplit les cases ; l’architecture rend leur rôle visible. Ce n’est pas encore un raisonnement démontré.
Le benchmark doit commencer là où le moteur s’arrête
Le moyen le plus rapide de produire une conclusion trompeuse serait de mélanger toutes les requêtes.
Prenons un corpus de 10 000 recherches réelles.
« Bosch perceuse 18 V », « peinture Dulux blanc 10 L » ou « vis 5×50 » peuvent représenter une part importante du trafic et laisser très peu de marge à JEV.
À l’opposé, des requêtes comme « peinture pour cave humide », « comment fixer une charge lourde dans du placo », « je veux isoler mon garage » ou « refaire joints douche moisissure » contiennent davantage d’intention implicite.
Le benchmark devrait donc segmenter les requêtes entre recherche produit explicite, produit avec attributs implicites, usage, problème, projet et demande multi-intentions.
Il faudrait ensuite comparer au minimum le moteur actuel, une version enrichie par des modèles spécialisés, une version utilisant un LLM avec sortie structurée, JEV, puis éventuellement un montage hybride JEV + LLM.
Les métriques offline doivent mesurer la classification et l’extraction d’attributs, mais également le top-k recall, le NDCG et le MRR des produits réellement proposés. La calibration mérite un test séparé : une confiance de 80 % n’a d’intérêt que si elle correspond à quelque chose d’utilisable pour fixer des seuils.
Puis vient la partie décisive, celle qui intéresse davantage le commerce : l’impact business
Est-ce que les utilisateurs cliquent sur des produits plus pertinents ? Reformulent-ils moins ? Trouvent-ils plus rapidement un premier produit acceptable ? Ajoutent-ils davantage au panier ? Les requêtes orientées projet conduisent-elles à un panier plus complet ? La conversion search évolue-t-elle ?
Enfin, il faut comptabiliser la contrepartie : latence p95, coût par requête, appels supplémentaires, maintenance des questions, complexité de debug et dépendance à une API ou à un nouveau modèle.
Le benchmark économique devrait donc ajouter au moins quatre mesures :
coût IA / 1 000 recherches
coût IA / commande issue du search
coût / requête correctement résolue
gain de marge ou de CA / dollar d'inférence supplémentaire
À cela s’ajoute une mesure particulièrement utile pour une architecture agentique :
nombre et coût des appels LLM évités grâce à JEVUne amélioration de classification n’est pas un business case. Une réduction de coût non plus. L’intérêt apparaît lorsque la qualité supplémentaire ou le coût évité se traduit dans l’économie complète du parcours.
La moyenne peut cacher toute la valeur
Imaginons que 75 % des requêtes soient déjà très bien traitées.
JEV ne change presque rien sur ces recherches et améliore fortement les 25 % restantes, précisément celles où l’utilisateur exprime un problème ou un projet.
La progression moyenne du NDCG peut paraître modeste.
Le résultat business peut pourtant être significatif si ces utilisateurs ont davantage de valeur (exemple : clients fidèles, clients professionnels), achètent plusieurs catégories ou abandonnent aujourd’hui faute de trouver comment transformer leur projet en produits.
L’inverse est également possible. Les démonstrations sur des requêtes complexes peuvent être impressionnantes alors que ces requêtes pèsent trop peu dans le chiffre d’affaires pour justifier une nouvelle infrastructure. < /mode usine à gaz > 😇
Il faut donc croiser qualité du modèle, fréquence du cas, coût d’inférence et valeur économique du parcours.
JEV devra gagner son droit d’entrer dans l’architecture
Trois résultats me semblent possibles.
Le premier est assez banal : JEV fonctionne correctement, mais le moteur actuel fonctionne déjà très bien. Les pertes de conversion viennent plutôt du prix, de la disponibilité, des données produits ou de la qualité de l’assortiment. Ajouter un modèle ne résout alors rien d’important, même s’il ne coûte presque rien à appeler.
Le deuxième est plus intéressant : JEV améliore la compréhension et le reranking d’un segment identifiable de requêtes longues, ambiguës ou orientées usage. Il devient une brique spécialisée du search. Son faible coût permet éventuellement de l’appliquer à un volume beaucoup plus large qu’un reranking effectué avec un LLM généraliste.
Le troisième dépasse la recherche. La même représentation structurée du besoin devient utilisable par le moteur, les recommandations, les règles métier et différents agents travaux. JEV prend en charge une partie des micro-décisions internes à faible coût, tandis qu’un LLM reste réservé au dialogue, à l’explication et aux cas qui demandent réellement une génération élaborée.
Dans ce scénario, le différentiel de coût n’est plus un simple avantage tarifaire. Il permet une division du travail entre modèles qui doit aussi se voir sur la qualité des réponses.
Le LLM conserve les tâches où sa généralité a de la valeur. JEV traite celles où elle constitue surtout un coût.
Cette hypothèse est séduisante, mais elle reste précisément cela : une hypothèse. JEV existe publiquement depuis quelques jours, TypeSafe le distribue encore en early access et ses résultats les plus spectaculaires en coût et en vitesse proviennent de benchmarks de l’éditeur. TypeSafe reconnaît d’ailleurs que les gains de 444,6× en coût publiés sur certains workflows sont probablement situés dans le haut de la fourchette des gains réels.
Ce qu’on peut déjà constater est plus sobre : le tarif public de JEV est inférieur de près de deux ordres de grandeur au tarif d’entrée de certains LLM frontier, tandis que sa sortie structurée n’est pas facturée. Ce différentiel s’inscrit dans une tendance à la spécialisation des modèles pour des taches simples. Il ne suffit pas pour conclure que JEV sera économiquement meilleur une fois intégrés qualité, volumes, maintenance et alternatives spécialisées.
La question peut maintenant devenir mesurable
La bonne expérimentation ne consiste donc pas à demander si JEV « comprend le bricolage ».
Elle consiste à prendre les requêtes que le moteur comprend mal aujourd’hui, à reconstruire explicitement les décisions nécessaires entre le besoin et le produit, puis à mesurer ce que JEV change à chacune de ces étapes.
- S’il classe mieux mais ne modifie pas les résultats, son intérêt est faible.
- S’il améliore le ranking sans améliorer le comportement client, le gain reste théorique.
- S’il coûte cent fois moins qu’un LLM sur une tâche qu’un simple classifieur réalise encore moins cher, le différentiel de prix n’a rien réglé.
- S’il permet en revanche de remplacer à grande échelle des appels LLM coûteux tout en conservant une qualité suffisante, le business case devient beaucoup plus concret.
Et s’il produit un état métier assez fiable pour être réutilisé à la fois par le search et par des agents spécialisés, la portée devient différente : le site ne cherche plus seulement à faire correspondre une requête à un produit. Il commence à transformer un projet en décisions commerciales et techniques.
À ce stade, c’est probablement là que se situe l’intérêt le plus crédible de JEV : mettre une intelligence spécialisée peu coûteuse sur les décisions fréquentes, et réserver l’intelligence générative plus chère aux situations ambiguës ou complexes qui en ont réellement besoin.