Les agents IA savent déjà rechercher des informations, utiliser des logiciels, produire du code et enchaîner des opérations pour atteindre un objectif. Pourtant, leur efficacité se dégrade souvent lorsqu’une mission s’étend sur plusieurs sessions, mobilise de nombreuses sources ou exige de tenir compte de décisions prises plusieurs semaines auparavant. Un agent peut parfaitement analyser les performances d’un site e-commerce le lundi et recommencer presque intégralement son diagnostic le vendredi, faute de retrouver les hypothèses testées entre-temps.
Cette discontinuité constitue une limite importante pour les applications qui ambitionnent de déléguer des responsabilités aux agents. Un responsable commercial, un acheteur ou un administrateur système ne prend pas chaque décision indépendamment des précédentes. Il mobilise son expérience, connaît les contraintes de son activité et conserve une représentation des dossiers en cours. Cette continuité permet de réduire les efforts de coordination, de corriger certaines erreurs et d’éviter de reprendre indéfiniment les mêmes analyses.
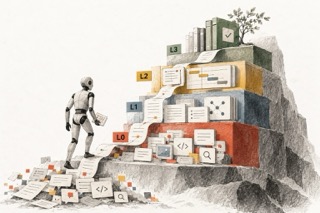
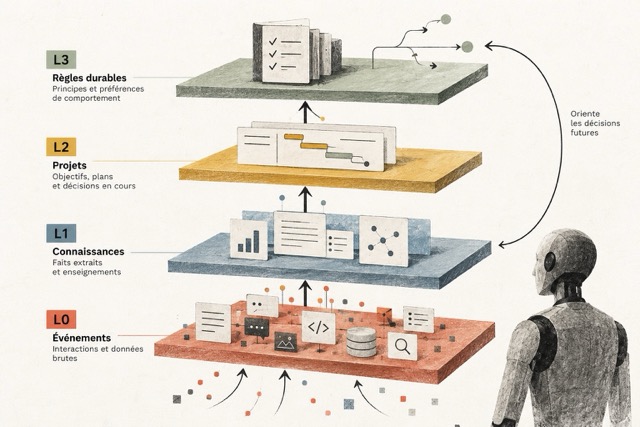
Une architecture de mémoire hiérarchisée peut apporter une partie de ces capacités aux agents IA. Le modèle à quatre niveaux L0–L3 distingue les événements bruts, les connaissances extraites, les projets et les règles durables de comportement. Chaque couche répond à un besoin particulier, mais leur intérêt repose surtout sur les relations qui les unissent.
Cette approche ouvre des perspectives concrètes pour l’automatisation des achats, le pilotage commercial, le support client ou la supervision des infrastructures. Elle soulève également des questions moins confortables : comment empêcher une information erronée de devenir une règle permanente ? Qui décide de ce qu’un agent doit retenir ? Et jusqu’où peut-on lui déléguer des décisions fondées sur des souvenirs dont la fiabilité varie ?
Pourquoi la mémoire conversationnelle atteint rapidement ses limites
La mémoire d’un assistant conversationnel est généralement envisagée comme un moyen de retrouver des échanges antérieurs ou des informations sur l’utilisateur. On conserve un historique, on en produit éventuellement un résumé, puis on récupère les passages pertinents lorsqu’une nouvelle demande arrive.
Cette approche convient à de nombreux usages. Elle devient moins satisfaisante lorsque l’agent doit conduire une activité dans la durée.
Prenons un agent chargé d’améliorer le référencement naturel d’un site marchand. Au cours d’une première intervention, il détecte des problèmes de maillage interne et recommande plusieurs corrections. Deux semaines plus tard, il constate une évolution du trafic. Pour interpréter cette variation, il doit retrouver les modifications réellement déployées, connaître les hypothèses initiales, distinguer les pages concernées et vérifier si d’autres changements ont eu lieu pendant la même période.
Un historique conversationnel peut contenir tous ces éléments sans fournir une représentation suffisamment organisée pour les exploiter efficacement. Le problème tient à la nature des informations conservées : une décision validée, une hypothèse abandonnée, une observation provisoire et une règle métier peuvent y apparaître sous la même forme, comme de simples fragments de texte.
Les travaux sur la mémoire des agents explorent plusieurs manières de dépasser cette limite. En 2023, l’étude Generative Agents: Interactive Simulacra of Human Behavior a proposé une architecture associant observation, récupération des souvenirs, réflexion et planification. Dans une simulation réunissant 25 agents, les chercheurs ont montré l’intérêt de ces mécanismes pour produire des comportements sociaux cohérents. Les résultats concernent cependant un environnement simulé, et non la fiabilité d’agents autonomes dans une organisation réelle. DOI
La même année, MemGPT a exploré une autre dimension du problème : la gestion de plusieurs niveaux de mémoire pour dépasser les contraintes de la fenêtre de contexte des modèles. Son architecture emprunte certains principes aux systèmes d’exploitation, notamment la circulation des informations entre espaces de stockage. arXiv
Ces recherches illustrent deux difficultés complémentaires. Il faut pouvoir conserver davantage d’informations que le modèle ne peut en traiter simultanément, puis sélectionner et organiser celles qui contribuent réellement à la décision.
Le modèle L0–L3 constitue une manière de structurer cette seconde dimension. Il doit être considéré comme un cadre architectural possible, et non comme un standard universel déjà adopté par les systèmes agentiques.
Quatre niveaux de mémoire pour organiser l’expérience
L’architecture repose sur une distinction entre quatre catégories d’informations, dont la durée de validité, la portée et les usages diffèrent.
L0 : conserver les événements
La première couche contient les interactions et les événements bruts : conversations, appels aux outils, résultats de recherche, transactions, modifications effectuées dans une application ou erreurs rencontrées.
Dans un système e-commerce, L0 peut enregistrer qu’un agent a modifié le classement de plusieurs produits à 10 h 30, qu’une promotion a commencé deux heures auparavant et que le taux de conversion a ensuite évolué.
Ces événements fournissent une base de traçabilité. Ils permettent de reconstruire une séquence d’actions et d’examiner les circonstances d’une décision. Leur conservation doit toutefois être proportionnée aux besoins opérationnels, aux coûts de stockage et aux obligations de protection des données.
L0 présente un inconvénient évident : son volume augmente rapidement. Une grande partie de son contenu perd toute utilité après quelques jours, tandis que certaines informations méritent d’être conservées beaucoup plus longtemps.
L1 : extraire des connaissances réutilisables
L1 contient des faits unitaires issus des événements, des sources métier ou des déclarations explicites.
Un utilisateur indique qu’il refuse les achats comportant des frais de livraison. Cette préférence peut être enregistrée dans L1. Un responsable e-commerce fixe un seuil minimal de marge pour une catégorie. L’information devient une contrainte commerciale consultable lors des opérations suivantes.
La fiabilité de cette couche dépend de la manière dont les connaissances sont qualifiées. Une préférence déclarée par un utilisateur n’a pas le même statut qu’une préférence inférée de ses achats. De même, une baisse de conversion observée après un changement de prix ne suffit pas à établir que ce changement en est la cause.
Chaque information devrait donc conserver son origine, sa date, son périmètre de validité et, lorsque cela se justifie, son niveau de confiance. Sans ces précautions, l’agent risque de transformer des observations circonstancielles en certitudes durables.
L2 : maintenir le contexte des projets
L2 organise les connaissances autour de situations opérationnelles : projet en cours, dossier client, mission commerciale, incident technique ou objectif personnel.
Cette couche peut conserver l’état d’avancement, les décisions prises, les hypothèses encore ouvertes et les dépendances entre les actions.
Un agent chargé d’optimiser une catégorie e-commerce peut ainsi retrouver le programme d’expérimentation engagé depuis plusieurs semaines. Il sait quelles fiches produits ont été modifiées, quels tests sont encore en cours et quels résultats nécessitent une vérification.
L2 présente un intérêt particulier pour l’autonomie : elle permet de reprendre une mission sans reconstruire l’ensemble de son contexte. Elle facilite également la coordination entre plusieurs agents intervenant sur un même dossier, sous réserve de disposer d’un état partagé cohérent et de règles de modification explicites.
Cette capacité existe déjà sous certaines formes dans les frameworks agentiques. LangGraph, par exemple, distingue la persistance de l’état d’exécution au moyen de checkpoints et le stockage d’informations durables utilisables entre différentes sessions. Cette distinction est proche de certaines préoccupations de L0–L3, sans correspondre exactement à ses quatre catégories. GitHub
L3 : conserver les orientations durables
La dernière couche regroupe les préférences générales, les objectifs de long terme et les conventions qui doivent guider plusieurs missions.
Pour un agent personnel, elle peut contenir une préférence pour les produits réparables, une sensibilité particulière à la confidentialité ou une manière habituelle de préparer les déplacements.
Pour un agent d’entreprise, elle peut intégrer le positionnement commercial, les principes de communication ou les priorités stratégiques.
Il convient cependant de distinguer ces orientations mémorisées des règles qui gouvernent effectivement les autorisations de l’agent. Une politique de sécurité, un plafond de paiement ou une restriction d’accès ne doivent pas pouvoir être modifiés simplement parce qu’un contenu enregistré en mémoire suggère de le faire.
La stabilité de L3 nécessite également un mécanisme de révision. Les préférences évoluent, les stratégies d’entreprise changent et certaines conventions deviennent obsolètes. Une mémoire durable qui ne peut pas être corrigée finit par produire des décisions inadaptées.
Comment les quatre couches interviennent dans une décision
Imaginons un utilisateur qui souhaite acheter un ordinateur portable.
L’agent consulte d’abord les informations générales conservées en L3 : l’utilisateur privilégie la durabilité du matériel et souhaite limiter ses dépenses lorsqu’un investissement n’apporte pas d’avantage substantiel.
Il retrouve ensuite, dans L2, le projet d’équipement de son bureau. Ce projet comporte un budget, plusieurs logiciels professionnels à faire fonctionner et une date de livraison souhaitée.
L1 apporte les caractéristiques de l’équipement déjà possédé, les contraintes techniques et les préférences explicitement formulées. Enfin, L0 permet de retrouver les comparaisons récentes, les offres précédemment refusées et les dernières interactions.
À partir de ces éléments, l’agent peut rechercher les produits disponibles, comparer leur coût total et préparer une recommandation. Si l’utilisateur a autorisé certains achats automatiques, il peut exécuter une commande dans les limites définies.
Après l’achat, la transaction est enregistrée. Les nouvelles informations utiles sont extraites et associées au projet. Une préférence durable ne sera éventuellement mise à jour qu’après confirmation ou selon une procédure de consolidation suffisamment fiable.
Le fonctionnement peut être représenté par une boucle : observation, extraction, contextualisation, décision, action, évaluation et mise à jour.
Le raisonnement de l’agent continue d’être produit par un modèle, éventuellement associé à un planificateur et à des outils. La mémoire lui fournit les éléments nécessaires pour tenir compte de l’expérience antérieure. Elle améliore les conditions de décision, sans garantir que la décision sera correcte.
11 agents dont les capacités pourraient évoluer grâce à cette mémoire
Les scénarios suivants décrivent des applications envisageables de l’architecture L0–L3. Ils illustrent des mécanismes et des possibilités de conception ; ils ne constituent pas des résultats expérimentaux démontrant les performances de cette architecture dans chacun des domaines.
1. Un agent qui achète pour son utilisateur
L’achat personnel constitue un terrain d’application particulièrement révélateur. Une bonne décision dépend rarement du seul prix affiché. Elle peut intégrer la compatibilité avec les équipements existants, les préférences de marque, les conditions de livraison, les achats déjà effectués et le budget disponible.
Imaginons un agent chargé de renouveler progressivement le matériel photographique de son utilisateur.
L0 conserve les recherches récentes, les prix observés, les propositions refusées et les transactions. L1 contient l’inventaire du matériel possédé, les compatibilités entre appareils et objectifs, ainsi que les contraintes budgétaires déclarées.
L2 maintient le projet de renouvellement : équipements à remplacer, budget total, achats déjà réalisés et prochaines échéances. L3 conserve les préférences durables, par exemple la priorité accordée à la qualité optique, à la réparabilité et à la conservation du matériel.
Cette organisation permet d’envisager des arbitrages plus pertinents que la simple comparaison de deux produits. Un appareil moins cher peut nécessiter le remplacement de plusieurs objectifs, tandis qu’un modèle plus coûteux reste compatible avec l’équipement existant.
L’agent pourrait également surveiller les prix et préparer un achat lorsqu’une offre satisfait les conditions définies. Il devrait néanmoins vérifier les prix et les stocks auprès des marchands au moment de la décision, puis respecter les autorisations de paiement.
La mémoire apporte ici une continuité dans la relation commerciale : chaque achat peut tenir compte des précédents et des objectifs encore à satisfaire.
2. Un agent chargé d’optimiser les performances d’un rayon e-commerce
Dans une activité marchande, les décisions portant sur le prix, l’assortiment, les promotions et le merchandising sont interdépendantes. Augmenter le chiffre d’affaires ne signifie pas nécessairement améliorer la rentabilité. Une promotion peut accélérer les ventes tout en dégradant la marge ou en provoquant une rupture prématurée.
Un agent chargé d’optimiser un rayon d’appareils photo pourrait suivre plusieurs objectifs simultanément : marge contributive, conversion, rotation des stocks et disponibilité des références stratégiques.
L0 documenterait les ventes, les changements de prix, les campagnes promotionnelles et les interventions de merchandising. L1 conserverait les contraintes commerciales, les caractéristiques produits et les résultats validés des expérimentations précédentes.
L2 réunirait les opérations en cours : optimisation d’une catégorie, lancement d’une gamme, préparation d’un événement commercial ou écoulement de stocks anciens. L3 définirait les orientations générales, notamment les priorités entre rentabilité, croissance et qualité de l’offre.
Supposons que l’agent observe une progression des ventes accompagnée d’une diminution de la marge.
Il pourrait rechercher les changements récents, analyser la contribution des différents produits et vérifier si une campagne promotionnelle explique une partie du phénomène. En consultant L2, il retrouverait également les tests déjà engagés sur le classement des références.
Une décision envisageable consisterait à modifier la mise en avant de certains produits, puis à mesurer les effets sur la marge et la conversion. Les résultats seraient conservés afin d’éviter de reproduire une expérimentation déjà invalidée.
L’intérêt économique dépendrait de la qualité des données, du volume d’activité et des marges de manœuvre autorisées. Une mauvaise estimation de l’élasticité au prix pourrait produire des décisions contre-productives malgré une mémoire parfaitement organisée.
L’apport de L0–L3 tient à la possibilité de conduire plusieurs cycles d’optimisation successifs en conservant leurs hypothèses, leurs résultats et leur contexte stratégique.
3. Un agent DevOps qui capitalise sur les incidents précédents
Les environnements informatiques produisent des volumes considérables d’événements : métriques, journaux techniques, alertes, déploiements et modifications de configuration. Une partie de ces informations devient particulièrement utile lorsqu’un incident se reproduit.
Imaginons un service qui connaît régulièrement des ralentissements pendant les périodes de forte activité.
L0 conserve les alertes, les métriques et les opérations techniques précédant chaque incident. L1 rassemble les dépendances du système, les symptômes identifiés et les procédures de remédiation dont l’efficacité a été vérifiée.
L2 maintient les dossiers d’incident, les migrations en cours et les opérations de maintenance susceptibles d’influencer le comportement du service. L3 contient les objectifs de disponibilité, les principes d’exploitation et les préférences organisationnelles en matière de risque.
Lorsqu’un nouvel incident apparaît, l’agent peut comparer les symptômes actuels aux événements antérieurs. Si une saturation de base de données avait déjà été identifiée, il dispose d’une piste de diagnostic immédiatement exploitable.
Il doit cependant vérifier cette hypothèse. Deux incidents présentant des symptômes similaires peuvent avoir des causes différentes, et appliquer automatiquement une ancienne correction pourrait aggraver la situation.
Dans un périmètre contrôlé, l’agent pourrait exécuter des diagnostics, ajuster certaines ressources ou proposer une procédure de restauration. Les interventions sensibles resteraient soumises aux politiques de changement et aux mécanismes d’approbation.
La mémoire permettrait alors de raccourcir certaines investigations et de conserver les enseignements des incidents, à condition que les procédures mémorisées soient régulièrement réévaluées.
4. Un agent qui gère les finances personnelles
Un agent financier pourrait suivre les dépenses courantes tout en tenant compte d’objectifs à plusieurs années. L0 conserverait les transactions, les échéances et les changements tarifaires. L1 regrouperait les charges récurrentes, les caractéristiques des contrats et les contraintes budgétaires. L2 représenterait les différents projets financiers : constitution d’une épargne de précaution, achat immobilier ou préparation d’une dépense importante. L3 préciserait les priorités générales et le niveau de risque accepté par l’utilisateur.
L’agent pourrait détecter une augmentation progressive des dépenses récurrentes, identifier les abonnements concernés et mesurer leur impact sur un objectif d’épargne. Il proposerait ensuite des arbitrages cohérents avec les engagements existants.
La difficulté principale serait de maintenir une vision fiable des comptes et des contrats sans exposer inutilement des données financières sensibles. La mémoire devrait également distinguer les objectifs déclarés des recommandations produites par l’agent. L’autorisation de consulter un compte ne saurait être assimilée à celle de transférer des fonds ou de souscrire un produit financier.
5. Un agent qui organise les voyages et réagit aux imprévus
La gestion des déplacements nécessite de coordonner plusieurs prestations dont les contraintes évoluent : transport, hébergement, rendez-vous et conditions d’annulation.
L0 enregistrerait les réservations, les modifications et les incidents. L1 conserverait les préférences de transport, les programmes de fidélité et les contraintes individuelles. L2 réunirait les informations propres à chaque déplacement, notamment les correspondances et les obligations professionnelles. L3 préciserait les arbitrages habituels entre coût, confort, durée et impact environnemental.
Lorsqu’un vol serait annulé, l’agent pourrait immédiatement identifier les conséquences sur les autres réservations et rechercher une solution adaptée. Il tiendrait compte de l’objectif du voyage, plutôt que de traiter uniquement la modification du billet.
La mémoire de projet serait particulièrement utile pour éviter qu’une nouvelle réservation crée une incompatibilité avec un rendez-vous ou une prestation déjà confirmée.
6. Un agent SEO qui apprend des optimisations précédentes
Le référencement naturel repose sur des interventions dont les effets peuvent être différés et difficiles à attribuer. La conservation des décisions antérieures constitue donc un enjeu opérationnel.
L0 enregistrerait les modifications de pages, les données de performance et les interventions techniques. L1 conserverait les connaissances sur les intentions de recherche, les caractéristiques des contenus et les problèmes identifiés. L2 organiserait les chantiers SEO : migration, optimisation de catégories, refonte du maillage interne ou développement d’un ensemble de contenus. L3 préciserait les exigences éditoriales et les priorités commerciales.
Un agent constatant une baisse de visibilité pourrait rapprocher cette évolution des modifications effectuées plusieurs semaines auparavant. Il retrouverait les hypothèses formulées lors de la refonte et identifierait les pages nécessitant de nouvelles investigations.
Cette mémoire contribuerait à limiter les audits redondants et les modifications successives dépourvues de suivi. Elle ne résoudrait toutefois pas les difficultés d’attribution causale : les évolutions des moteurs de recherche, les interventions concurrentes et les changements de demande continueraient à influencer les résultats.
7. Un agent qui anticipe les ruptures et optimise les approvisionnements
La gestion des stocks dépend d’informations dispersées entre les ventes, les fournisseurs, la logistique et les opérations commerciales.
L0 conserverait les commandes, les réceptions, les incidents de livraison et les variations de stock. L1 regrouperait les délais fournisseurs observés, les contraintes d’approvisionnement et les paramètres de prévision. L2 suivrait les opérations commerciales susceptibles de modifier la demande, ainsi que les projets de changement de fournisseur. L3 préciserait la politique de couverture des stocks et les arbitrages entre disponibilité, trésorerie et risque de rupture.
Si un fournisseur annonçait un retard, l’agent pourrait identifier les références concernées, examiner les opérations commerciales à venir et proposer des solutions d’approvisionnement alternatives.
Les stocks réels et les commandes confirmées devraient cependant être vérifiés auprès des systèmes de gestion. La mémoire conserverait principalement les décisions, les exceptions et les enseignements utiles aux prochains arbitrages.
8. Un agent commercial qui connaît l’histoire de chaque opportunité
Les cycles de vente B2B peuvent s’étendre sur plusieurs mois et mobiliser différents interlocuteurs. Cette durée favorise la dispersion des informations entre emails, réunions, documents et CRM.
L0 conserverait les échanges et les propositions commerciales. L1 regrouperait les besoins exprimés, les objections et les critères de décision. L2 maintiendrait le contexte de chaque opportunité, son historique de négociation et les prochaines actions. L3 intégrerait les principes commerciaux, le positionnement de l’entreprise et les règles de négociation.
Lorsqu’un prospect reprendrait contact après plusieurs mois, l’agent pourrait retrouver les raisons de l’interruption du projet et préparer une proposition adaptée aux discussions précédentes.
Il devrait également distinguer les informations encore valides de celles nécessitant une nouvelle confirmation. Un budget annoncé six mois auparavant, par exemple, ne constitue pas nécessairement une contrainte toujours applicable.
9. Un agent de support qui évite de recommencer les mêmes diagnostics
Un client confronté à un problème récurrent doit souvent expliquer plusieurs fois la même situation, particulièrement lorsque son dossier change d’interlocuteur ou de canal.
L0 conserverait les tickets, les échanges et les interventions. L1 regrouperait les caractéristiques techniques du produit, les problèmes connus et les solutions déjà testées. L2 suivrait les dossiers complexes nécessitant plusieurs interventions. L3 préciserait les engagements de service et les conditions d’escalade.
Lorsqu’un client signalerait une quatrième occurrence du même incident, l’agent pourrait identifier les diagnostics déjà effectués et transmettre directement le dossier au niveau de support approprié.
La mémoire réduirait les répétitions et faciliterait la continuité du traitement. Elle permettrait également d’identifier des problèmes récurrents concernant plusieurs clients, à condition de disposer de mécanismes d’agrégation respectueux des droits d’accès et de la confidentialité.
10. Un agent de veille stratégique qui conserve le contexte des évolutions du marché
Une veille concurrentielle produit continuellement de nouveaux signaux : lancements de produits, modifications tarifaires, annonces technologiques, recrutements ou acquisitions.
L0 conserverait les publications et événements observés, avec leurs sources et leurs dates. L1 organiserait les informations vérifiées sur les entreprises, les produits et les marchés. L2 relierait ces observations aux projets stratégiques en cours. L3 préciserait le positionnement de l’organisation et ses priorités de développement.
L’annonce d’une nouvelle offre concurrente pourrait ainsi être rapprochée d’un projet interne déjà engagé. L’agent serait en mesure d’identifier les fonctionnalités comparables, les différences de positionnement et les conséquences possibles sur les choix de développement.
La qualité des résultats dépendrait fortement de la distinction entre annonces, réalisations effectives et hypothèses. Une mémoire stratégique qui accumule des déclarations commerciales sans vérifier leur portée risque de produire une représentation trompeuse du marché.
11. Un agent qui pilote l’amélioration continue de l’expérience utilisateur
L’optimisation UX mobilise des données comportementales, des recherches qualitatives, des expérimentations et des décisions de conception. Ces informations sont souvent dispersées entre plusieurs outils et équipes.
L0 enregistrerait les observations, les résultats des tests et les modifications d’interface. L1 conserverait les problèmes d’utilisabilité documentés, les besoins identifiés et les enseignements validés. L2 suivrait les chantiers d’amélioration, leurs hypothèses et les expérimentations en cours. L3 préciserait les principes de conception, les exigences d’accessibilité et les objectifs d’expérience utilisateur.
Si le taux d’abandon d’un checkout augmente, l’agent pourrait retrouver les modifications récentes, consulter les problèmes déjà identifiés et vérifier les expérimentations précédemment menées.
Il pourrait ensuite proposer un nouveau test en tenant compte des résultats antérieurs. La mémoire éviterait de répéter inutilement certaines recherches et faciliterait la capitalisation entre équipes produit.
Cette continuité serait particulièrement utile dans les organisations où les responsables changent régulièrement de projet. Les décisions de conception conserveraient leur justification au-delà des personnes qui les ont initialement prises.
La mémoire de projet pourrait devenir le pivot de l’autonomie
Les onze exemples révèlent une caractéristique commune : les bénéfices les plus importants apparaissent lorsque l’agent doit maintenir une mission dans la durée.
La mémoire L0 permet de retrouver les événements. L1 organise les connaissances. L3 fournit des orientations relativement stables. Mais L2 introduit une dimension supplémentaire en associant ces informations à un objectif dont l’état évolue.
Cette distinction mérite d’être approfondie.
Un agent SEO peut connaître toutes les caractéristiques d’un site sans savoir quelles optimisations sont déjà engagées. Un agent commercial peut disposer d’un historique complet des échanges sans identifier les engagements encore ouverts. Un agent DevOps peut connaître plusieurs procédures de réparation sans savoir qu’une migration en cours interdit temporairement certaines interventions.
Dans ces trois situations, les informations disponibles peuvent être exactes. Leur utilisation dépend néanmoins du contexte opérationnel.
L2 peut précisément conserver ce contexte : objectifs, hypothèses, décisions, dépendances et étapes restantes. Cette représentation facilite la reprise d’une mission après une interruption et fournit des éléments au planificateur chargé de déterminer les prochaines actions.
Il serait toutefois excessif d’en déduire que L2 doit nécessairement prendre la forme d’une nouvelle base de données. Un CRM, un outil de gestion de projet ou un orchestrateur de workflows contiennent déjà une partie de ces informations. Selon les systèmes, la meilleure solution peut consister à exploiter ces sources existantes plutôt qu’à en reproduire le contenu dans une mémoire dédiée.
L’hypothèse à examiner est donc plus précise : une représentation persistante de l’état opérationnel des missions peut améliorer la continuité des agents, indépendamment du système utilisé pour la stocker.
Pour vérifier cette hypothèse, il faudrait comparer plusieurs architectures sur des missions longues, en mesurant notamment la capacité à reprendre une activité interrompue, le nombre d’actions redondantes, les erreurs liées à des informations obsolètes et le coût de récupération du contexte.
Une mémoire persistante introduit aussi de nouveaux risques
Conserver davantage d’informations augmente les possibilités de contextualisation, mais crée également de nouvelles contraintes techniques et organisationnelles.
La première concerne la qualité des connaissances. Un agent peut mal interpréter une conversation, attribuer une préférence à la mauvaise personne ou généraliser abusivement une observation. Si cette information est ensuite conservée dans L3, elle risque d’influencer de nombreuses décisions ultérieures.
La consolidation doit donc s’appuyer sur des règles explicites. Les informations déclarées, inférées et vérifiées doivent rester distinguables. Certaines connaissances doivent expirer automatiquement, tandis que d’autres nécessitent une confirmation avant d’être considérées comme durables.
La deuxième difficulté concerne les contradictions. Une organisation peut décider de privilégier la croissance pendant plusieurs mois, puis réorienter sa stratégie vers la rentabilité. Un agent doit pouvoir réviser ses orientations sans perdre l’historique des décisions qui avaient été prises dans le contexte précédent.
La troisième difficulté touche à la sécurité. Une mémoire persistante constitue une surface d’attaque supplémentaire. Une instruction malveillante introduite dans un document, un email ou une réponse d’outil pourrait être interprétée comme une connaissance fiable, puis réutilisée lors de sessions ultérieures. Les travaux de l’OWASP consacrés à l’empoisonnement de la mémoire des agents examinent précisément ce type de menace. owasp.github.io
Une architecture de production devrait donc contrôler les opérations d’écriture et de lecture, conserver la provenance des informations sensibles et permettre la révision des connaissances compromises. Les permissions d’accès et les autorisations d’action devraient relever de mécanismes indépendants de la mémoire.
Enfin, la conservation des informations a un coût. Il faut stocker les événements, extraire les connaissances, gérer les mises à jour et sélectionner le contexte pertinent lors de chaque décision. Une architecture sophistiquée peut ainsi devenir économiquement disproportionnée pour des tâches simples ou rarement répétées.
Le bon niveau de mémoire dépend de la durée des missions, de la fréquence des interactions et de la valeur des décisions concernées. Un agent chargé de produire ponctuellement un résumé n’a généralement pas besoin des mêmes mécanismes qu’un agent supervisant quotidiennement plusieurs milliers de références commerciales.
Jusqu’où faut-il laisser un agent exploiter son expérience ?
La mémoire hiérarchisée pourrait contribuer à résoudre certaines difficultés qui limitent actuellement l’autonomie des agents : perte de contexte, répétition des analyses, faible capitalisation sur les décisions et fragmentation des projets.
Son efficacité dépendra pourtant moins du nombre de souvenirs conservés que de la capacité du système à sélectionner des informations pertinentes, à reconnaître leur fiabilité et à les réviser lorsque les circonstances changent.
Dans un environnement commercial, cette capacité pourrait améliorer la continuité des arbitrages entre marge, conversion et disponibilité. Dans le support client, elle faciliterait la résolution de dossiers complexes. Dans l’exploitation informatique, elle permettrait de réutiliser des diagnostics antérieurs tout en conservant les conditions dans lesquelles ils avaient été établis.
Ces perspectives restent à évaluer sur des missions réelles. La présence de quatre couches de mémoire ne démontre pas, en elle-même, une amélioration des performances. Celle-ci devrait être mesurée à travers la qualité des décisions, leur coût, les erreurs évitées et la capacité de l’agent à reprendre correctement une activité interrompue.
Une conséquence organisationnelle mérite également d’être examinée. À mesure que les agents conserveront davantage de connaissances et de décisions, les entreprises devront définir qui peut consulter, modifier ou invalider cette mémoire. La question deviendra particulièrement sensible lorsqu’un même agent travaillera pour plusieurs équipes ou lorsqu’une décision automatisée produira des conséquences financières.
Un agent d’achat peut être autorisé à commander certains produits. Un agent e-commerce peut disposer d’une marge de manœuvre sur le merchandising. Un agent DevOps peut exécuter des opérations techniques limitées. Dans chacun de ces cas, l’autonomie repose sur la combinaison d’un contexte fiable, d’outils adaptés et d’autorisations explicites.
La mémoire structurée rend envisageable une délégation plus durable, parce que l’agent dispose des éléments nécessaires pour inscrire ses actions dans une histoire et poursuivre des objectifs. Elle impose, en contrepartie, une responsabilité nouvelle : organiser la manière dont les agents construisent leurs connaissances, les utilisent et acceptent de les remettre en cause.